

Referenztabellen braucht man in einer Data Solution an vielen Stellen, mal um etwas zu verkodieren, mal um es wieder zu dekodieren, gerade wenn personenbezogene Daten im Spiel sind. Wer ein Star Schema nutzt, sollte davon allerdings nichts mehr merken, denn dort muss das schon passiert sein. Die Daten kommen also von woanders her, und trotzdem sieht der Nutzer nur das fertige Ergebnis.
In Teil 1 dieser Serie ging es darum, was ein Datenprodukt ist, am Beispiel eines Star Schemas fürs Accounting mit rund 15 Tabellen. Offen blieb, woher die Daten kommen, die in diese Box hineinfließen. Dort hatte ich Kunde und Mitarbeiter als Beispiel genannt. Fürs Accounting passt die Kostenstelle besser, deshalb nehme ich hier sie.
An der Kostenstelle illustriere ich zwei weitere Fragen: wo ein Datenprodukt aufhört und wie man es so bereitstellt, dass es auch den ersten Breaking Change übersteht.
Woher die Daten kommen

Zwei Zuflüsse, ein Ergebnis für den Nutzer.
In die Box eines Datenprodukts fließen die Daten auf zwei Wegen. Entweder kommen sie über die eingehenden Schnittstellen der Vorsysteme, und mehr verantwortet das Team auf der Quellseite auch nicht. Oder das Datenprodukt nutzt andere Datenprodukte.
Der zweite Weg ist der spannendere. Das Accounting-Star-Schema braucht die Kostenstellen als Dimension, gepflegt werden sie aber woanders. Gibt es dafür schon ein Datenprodukt, weil ein Stammdaten-Team es gebaut hat, verwende ich es einfach wieder.
Ob Stammdaten ein eigenes Datenprodukt sein müssen, darüber kann man streiten. Ich sehe das pragmatisch: Es lohnt sich, weil jemand dafür verantwortlich ist und sich darum kümmert. Nicht jede Tabelle ist ein Datenprodukt, aber ich muss auch nicht dogmatisch sagen, das hier ist keins.
Für den Nutzer des Star Schemas ändert das nichts. Er soll nicht selbst mit den Kostenstellen joinen, verkodieren oder dekodieren müssen. Das erledigt das Accounting-Team beim Befüllen des Star Schemas, und beim Nutzer kommt die Kostenstelle als integrierte Dimension an. Ein Datenprodukt nutzt also ein anderes, und wer es abonniert, sieht davon nur das Ergebnis.
Wo ein Datenprodukt aufhört
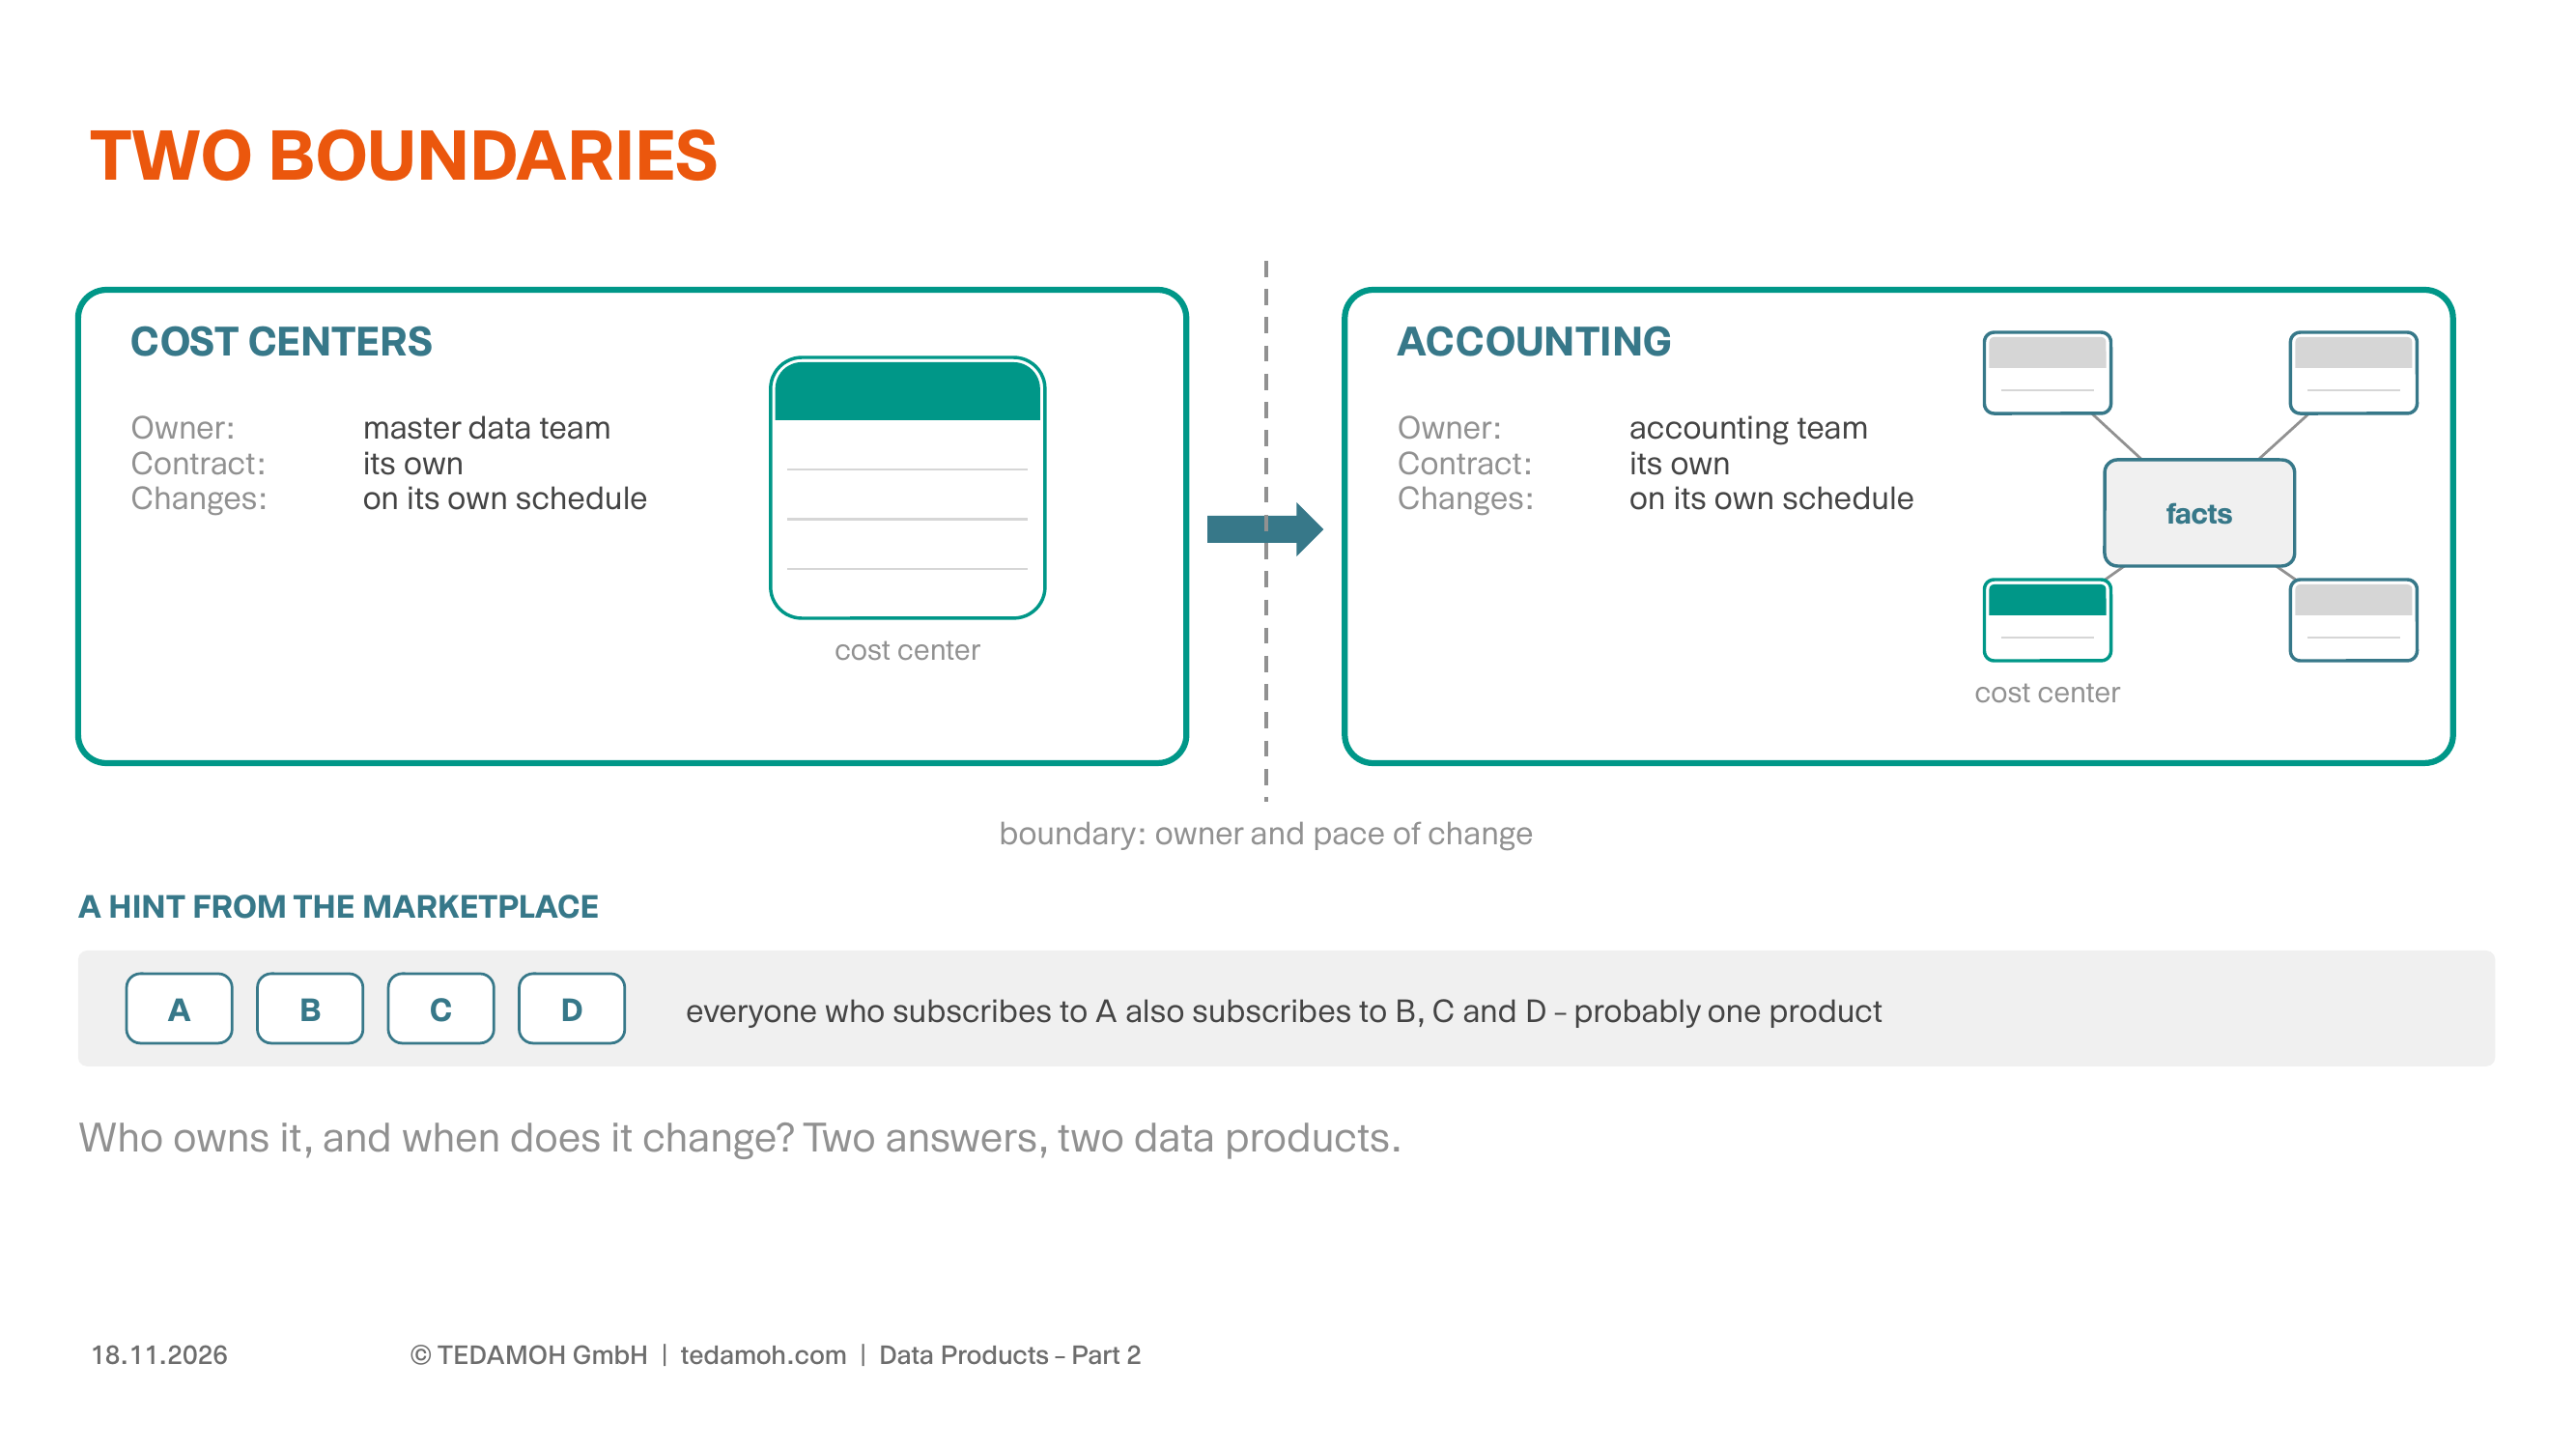
Zwei Teams, zwei Contracts, zwei Datenprodukte.
In Teil 1 habe ich die Grenze vom Nutzer her gezogen: Ein Datenprodukt reicht so weit wie der Bedarf seines Nutzungskreises. Mit der Kostenstelle kommt eine zweite Grenze dazu, und die zieht der Eigentümer. Wer verantwortet es, und wann ändert es sich?
Die Kostenstellen gehören dem Stammdaten-Team, die Kostenverrechnung gehört dem Accounting. Beide Teams ändern in ihrem eigenen Takt, also sind es zwei Datenprodukte, auch wenn die Kostenstelle im Star Schema als Dimension mit drinsteckt.
Als Maßstab nehme ich, was sinnvoll zusammengehört und deshalb gemeinsam ausgeliefert wird. Dabei denke ich gleich an später, an die Wartung und an die Versionierung, wenn ein Breaking Change kommt. Ein gutes Indiz liefert der Marktplatz, auf dem die Datenprodukte angeboten werden: Wenn alle, die eine Tabelle abonnieren, auch dieselben drei anderen abonnieren, gehören die vier wahrscheinlich in ein Produkt. Bestellungen und Bestellpositionen aus dem Hub-Artikel sind so ein Fall.
Über diese Serie: Dies ist Teil 2 von 3 der Serie „Datenprodukte: Vom Modell zum Mehrwert“. Die Übersicht steht im Hub-Artikel. Teil 1 klärt, was ein Datenprodukt ist. Teil 3 (9. Dezember) geht der Automatisierung durch Informationsmodelle nach.
Dimensionen modellieren, Module bauen
Was SCD Typ 1 und Typ 2 für eine Dimension bedeuten, gehört zur Dimensional Modeling Fundamentals Class. Wie Module unabhängig voneinander laufen, zeige ich in Master the Art of Data Engine Thinking, als eLearning und als Präsenztraining - aktuelle Termine auf unserer Webseite.
→ Zur Dimensional Modeling Fundamentals Class
→ Zu Master the Art of Data Engine Thinking
Bereitstellen, auch beim Breaking Change
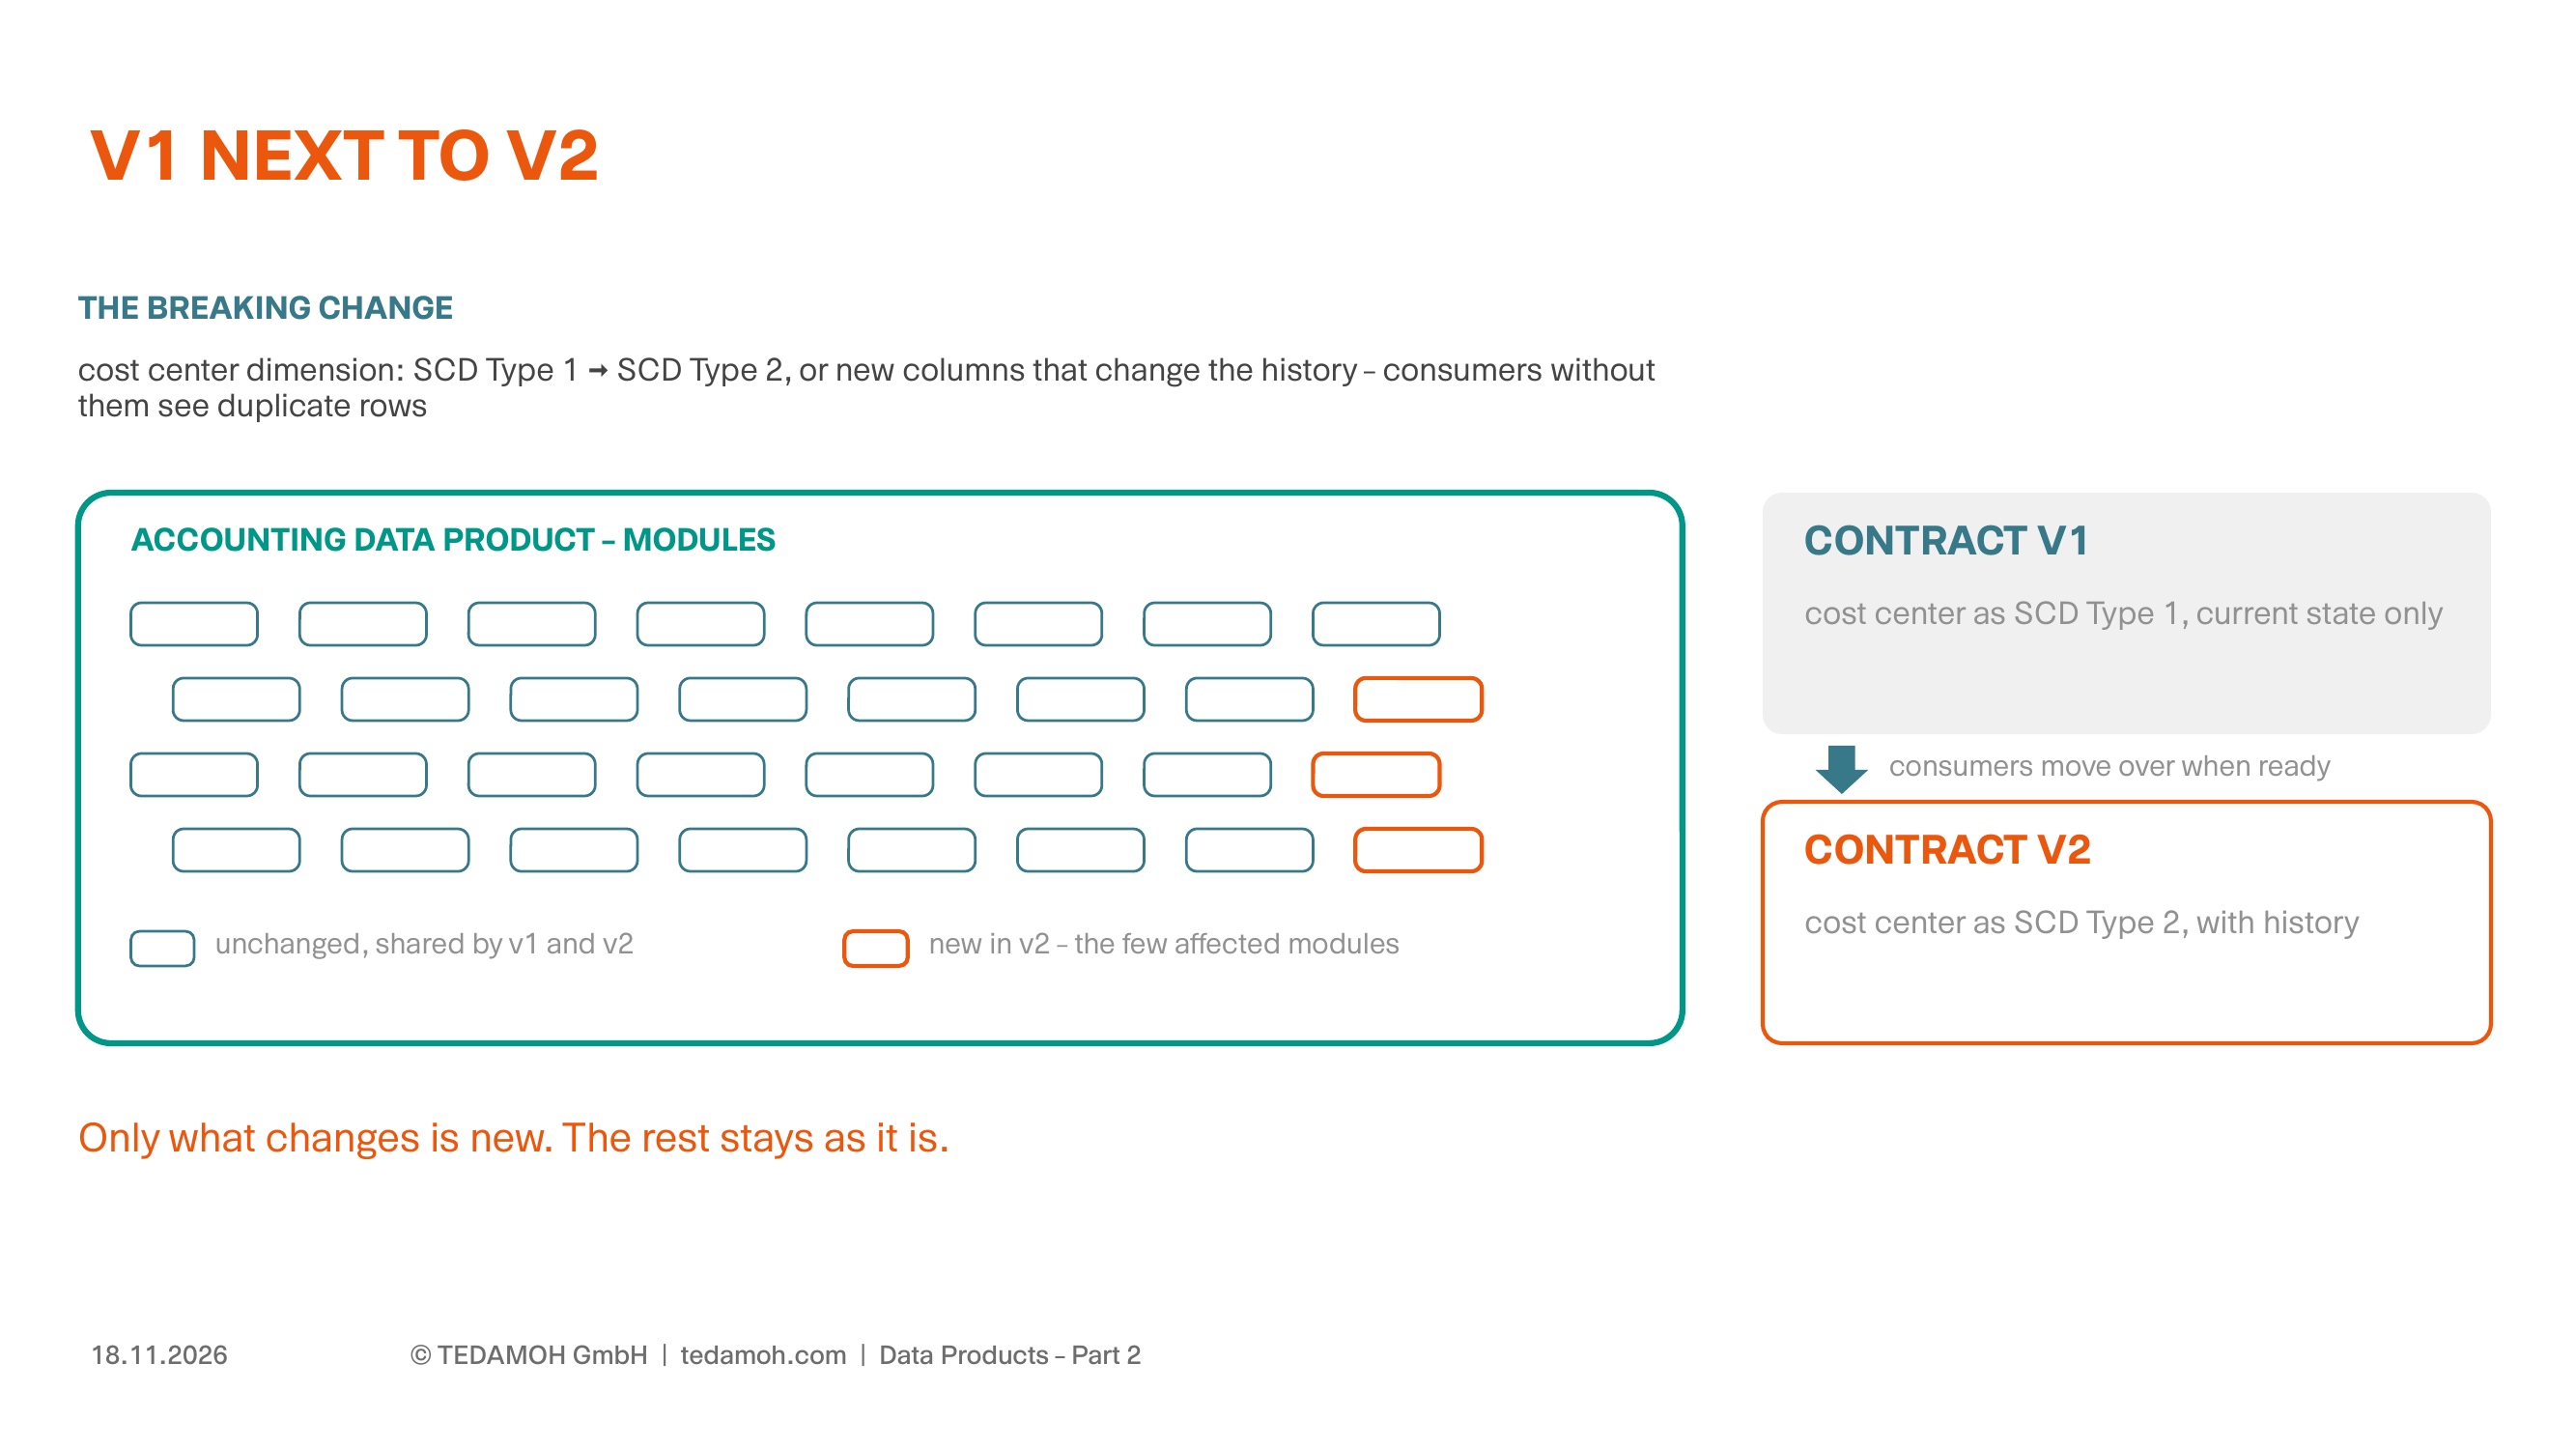
Neu ist nur, was sich ändert.
Der Contract aus Teil 1 garantiert dem Nutzer, dass nichts einfach gelöscht oder umbenannt wird. Irgendwann ändert sich trotzdem etwas so, dass es nicht mehr zum bisherigen Contract passt. Das ist der Breaking Change.
Im Beispiel könnte das so aussehen: Die Kostenstellendimension war bisher nach SCD Typ 1 aufgebaut, also immer nur mit dem aktuellen Stand, und wird jetzt historisiert (SCD Typ 2). Oder sie war schon SCD Typ 2 und bekommt neue Spalten, die die Historisierung verändern. Für Nutzer, die das nicht auf dem Schirm haben, kann das schwere Folgen haben. Sie brauchen die neuen Spalten nicht, und aus ihrer Sicht stehen auf einmal doppelte Datensätze in der Dimension.
Die Antwort darauf steht schon im Hub: Version 2 neben Version 1 stellen, und die Nutzer ziehen um, wenn sie so weit sind. Das heißt aber nicht, dass ich das ganze Datenprodukt kopiere. Hinter einem Star Schema stecken vielleicht dreißig Module (Data-Logistik-Prozesse), und vom Wechsel auf SCD Typ 2 sind davon eins, zwei oder drei betroffen. Nur die kommen in einer neuen Fassung dazu. Was gleich bleibt, bleibt, wie es ist, und muss auch nicht kopiert werden. Das geht, weil die Module in Data Engine Thinking unabhängig voneinander laufen: Ein neues Modul kommt dazu, und an den bestehenden ändert sich nichts.
Und wenn der Breaking Change von außen kommt? Historisiert das Stammdaten-Team seine Kostenstellen, ist das Accounting-Team selbst der Nutzer. Genau dafür lohnt sich die zweite Grenze. Die Kostenstelle hat ihren eigenen Contract und ihre eigene Version, und das Accounting-Team entscheidet, wann es umzieht. Seine eigenen Nutzer merken davon erst etwas, wenn es selbst eine neue Version bereitstellt.
Bei zwei Teams und zwei Contracts fällt allerdings sofort etwas auf: Jedes Team beschreibt die Kostenstelle in seinem Contract selbst, und nicht unbedingt mit denselben Worten. Wie ein Informationsmodell dafür sorgen kann, dass sie trotzdem überall dasselbe bedeutet, und was sich daraus automatisieren lässt, ist das Thema von Teil 3 am 9. Dezember. Vorher erscheint am 24. November Folge #005 von [antifragile data], in der ich mit Simon Harrer über Datenprodukte spreche.
So long,
Dirk
Quellen
Das Accounting-Star-Schema ist das Unterrichtsbeispiel aus der Dimensional Modeling Fundamentals Class. Das Prinzip unabhängiger Module stammt aus Roelant Vos und Dirk Lerner, Data Engine Thinking.