

Das fachliche Modell liegt fertig auf dem Tisch, und ab hier wird gebaut. Der kürzeste Weg der Implementierung von der Quelle bis zum fertigen Bericht ist der, eine ganze Schicht der Architektur auszulassen, und er funktioniert auch — jedenfalls so lange, wie die Annahmen halten, unter denen man ihn gewählt hat.
Bei FastChangeCo will Terence Tindle, BI Architect, genau jetzt loslegen. FastChangeCo ist die fiktive Firma, an der ich reale Situationen aus Projekten und Coachings greifbar mache.
In Teil 1 ging es um eine Bedeutung, die es gab und die auf dem Weg zur Spalte verloren ging, in Teil 2 um eine, die nie jemand entschieden hat. Bei FastChangeCo ist sie inzwischen entschieden: Was ein Employee ist, steht fest, die Subtypen auch, und zu jedem gehört ein Verantwortlicher. Damit ist die Methodenfrage dran. Sie ist weder Geschmackssache noch ein Glaubenskrieg. Sie ist abhängig von der Schicht in der Data-Warehouse-Architektur, für die man eine Methode wählt, und davon, welche Konsequenzen — positive wie negative — sie in zwei Jahren hat.
Es gibt keine beste Methode, es gibt Schichten
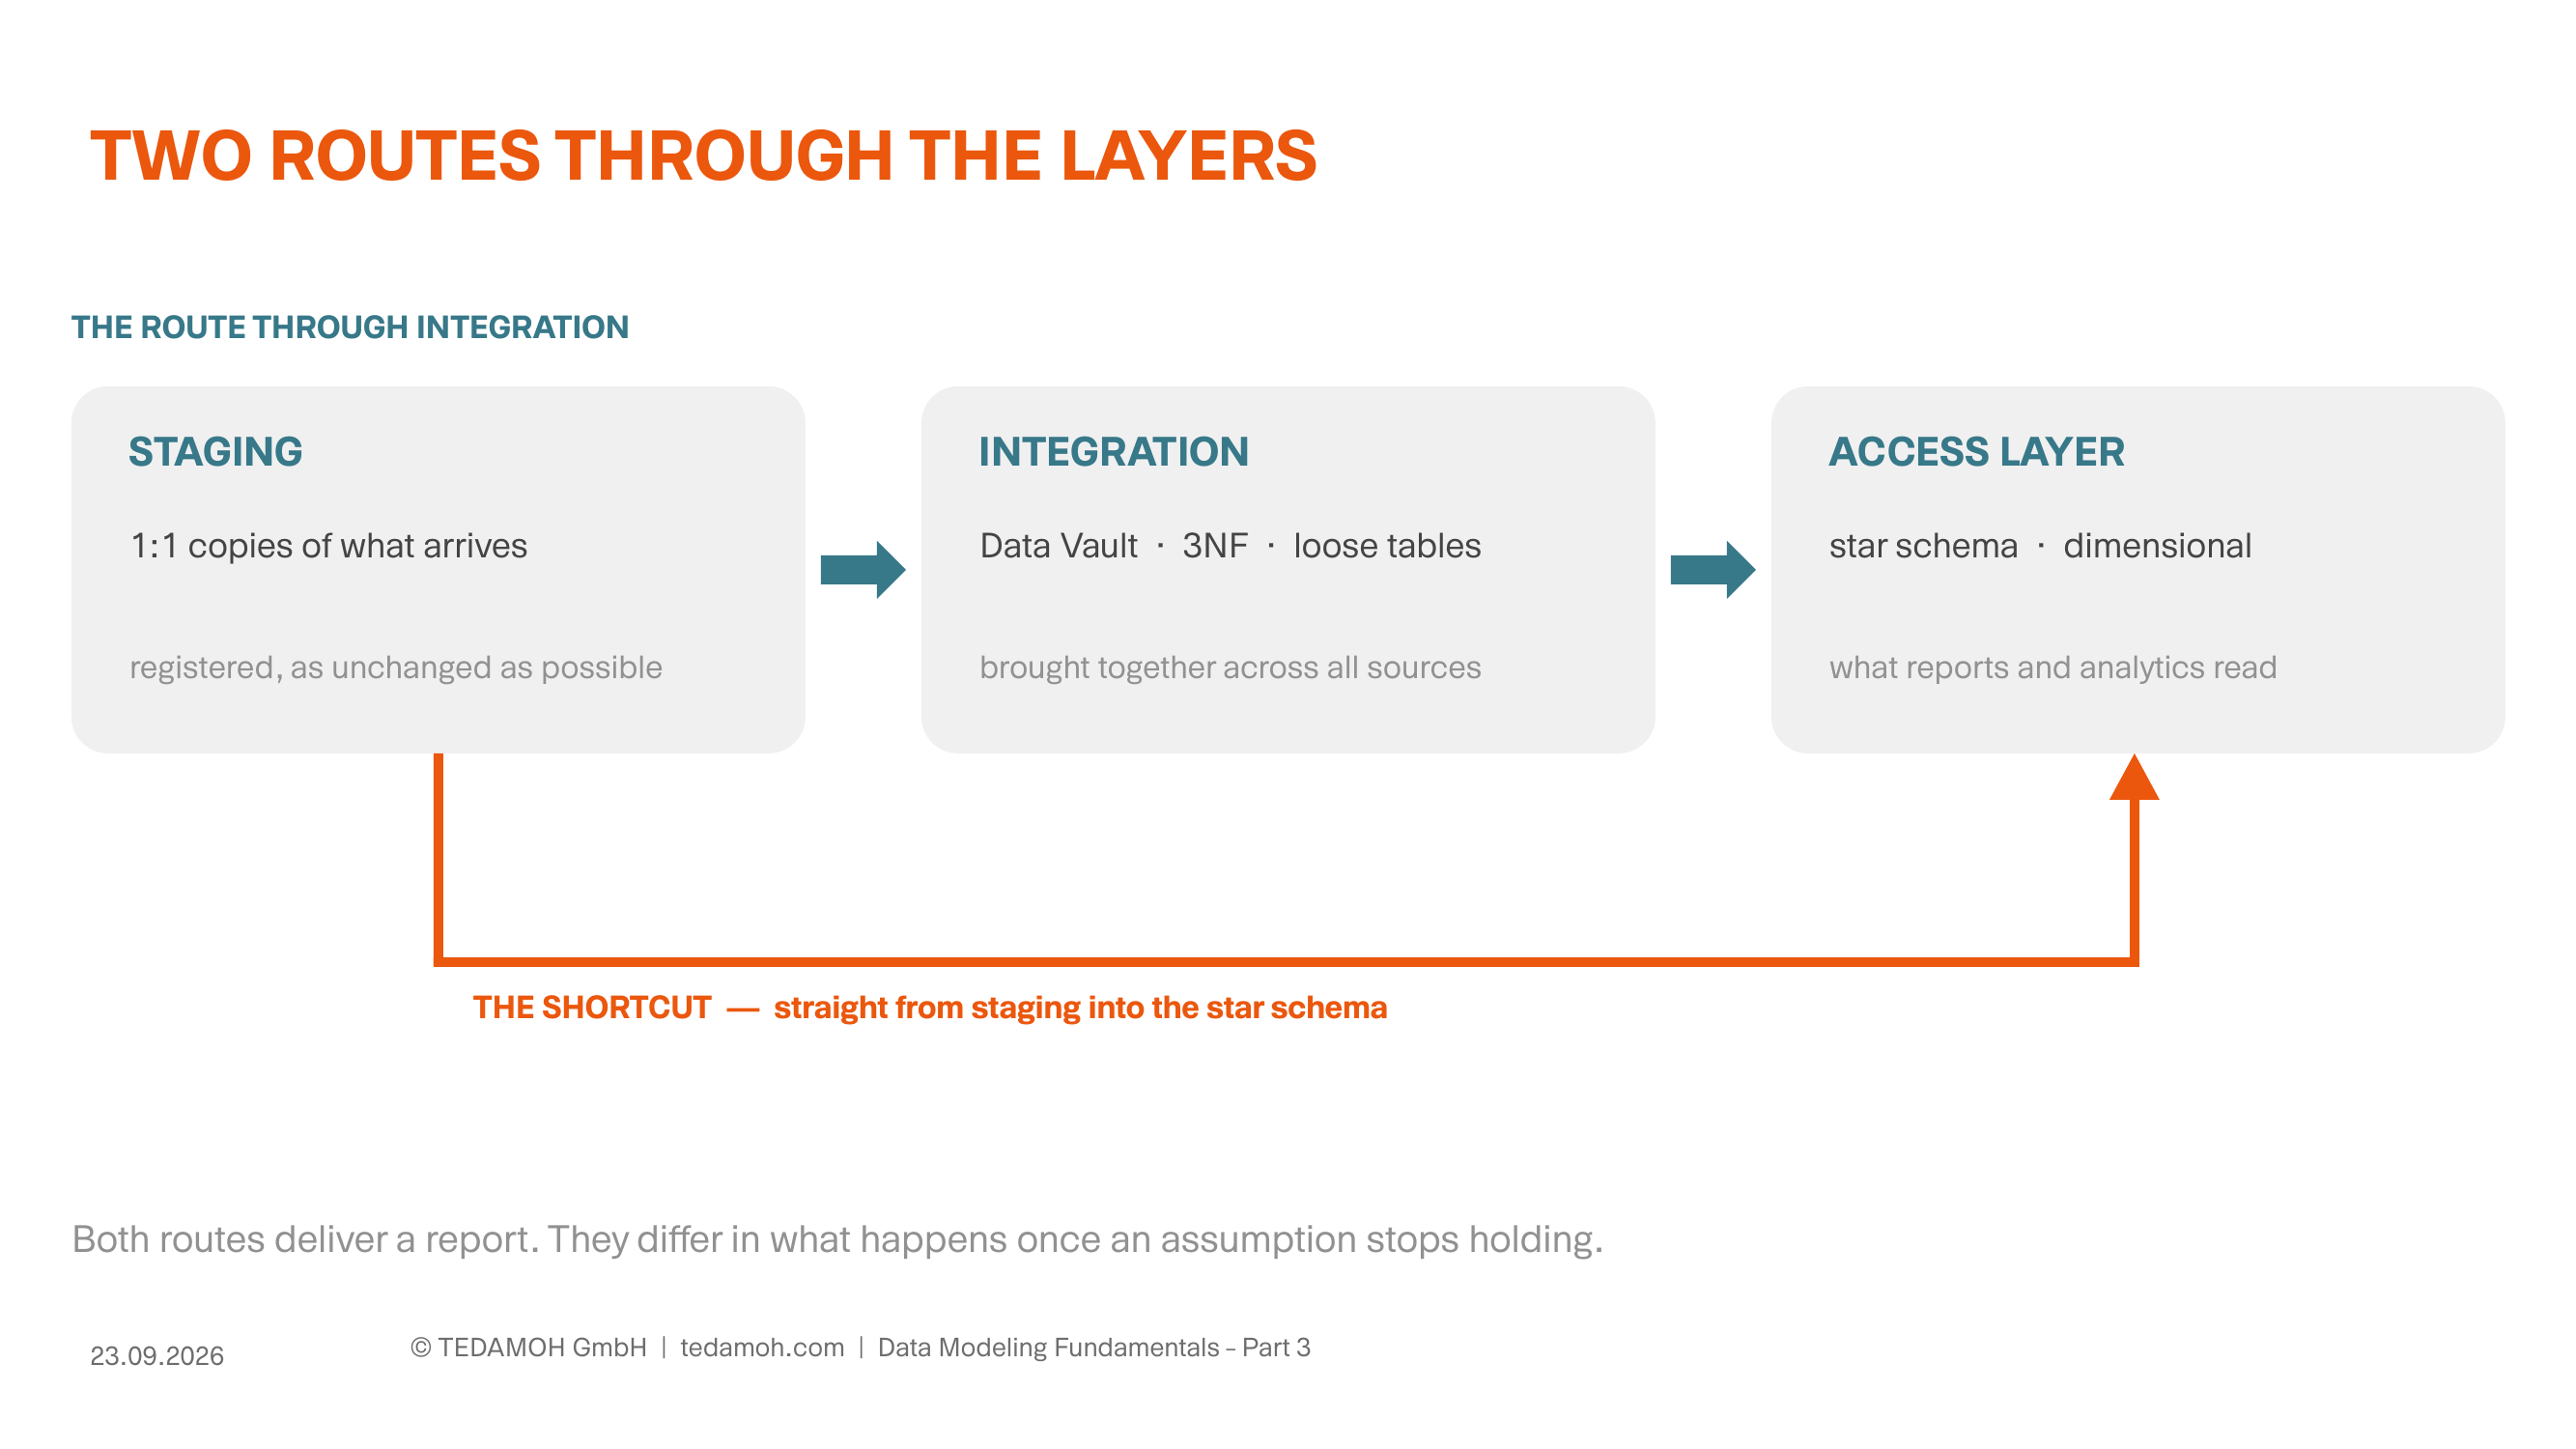
Zwei Wege von der Quelle zum Bericht. Der eine geht durch die Integrationsschicht, der andere daran vorbei.
Amal bringt das konzeptionelle Modell mit in den Termin. Terence denkt sofort in Star Schema, weil er damit das Dashboard bauen soll. Jeff Jones aus der IT hält dagegen, 3NF sei im Haus und damit kämen alle zurecht. Die beiden reden aneinander vorbei: Ihre Methoden konkurrieren gar nicht, sie gehören auf verschiedene Schichten.
Bill Reynolds, Chief Data Architect, hat dafür ein Bild, das ich mir gerne borge. Mit „Big Data“ sei die Datenmodellierung in die Wüste geschickt worden — Struktur sei optional, die Werkzeuge würden das schon richten —, und dort wanderten zwanzig Jahre lang die Stämme der 3NF-, Dimensional-, Graph- und Data-Vault-Modellierer, bis sie sich nach und nach wiederfanden. Sein Punkt ist, dass Modellierung gerade jetzt wieder an Gewicht gewinnt, weil Lakehouses, Datenprodukte und KI-Pipelines sie nicht ersetzen, sondern verstärken. Für diesen Artikel zählt das Stück dazwischen: Die Frage ist nicht, welcher Stamm recht hat, sondern welche Schicht gerade dran ist.
Eine Datenlösung hat grob gesagt drei davon, und die Daten laufen von links nach rechts hindurch. Ganz links steht das Staging: Es registriert, was aus den Quellsystemen hereinkommt, möglichst unverändert. Dahinter die Integrationsschicht, in der über alle Quellen hinweg zusammengeführt und angereichert wird. Rechts am Ende der Access Layer — die Schicht, aus der Berichte und Auswertungen lesen.
Drei Methoden stehen dafür zur Auswahl, und jede hat ihre Schicht. 3NF (dritte Normalform) räumt Redundanz aus einem Modell heraus, so dass jede Aussage genau einmal gespeichert ist. Data Vault zerlegt ein Modell in Geschäftsschlüssel, Beziehungen und beschreibende Attribute; es historisiert von Haus aus und lässt sich weitgehend generieren — wie so ein Modell im Kleinen aussieht, steht im Coaching-Guide zu Link und Satellite. Und die dimensionale Modellierung ordnet Kennzahlen und ihre Auswertungsdimensionen so an, dass ein Bericht wenig Arbeit damit hat; das Star Schema ist ihre bekannteste Ausprägung, aber nicht dasselbe.
Was sich in meinen Projekten bewährt hat, ist meist dieselbe Kombination: Data Vault in der Integration, Star Schema im Access Layer. Ein Naturgesetz ist das nicht, abweichen darf man jederzeit. Die Abweichung braucht nur einen Grund, und der gehört aufgeschrieben. Im Kern ist das schon der ganze Entscheidungsbaum.
Die Abkürzung und ihre Rechnung
Jeff geht in dem Termin noch einen Schritt weiter. Die Personaldaten kämen ordentlich herein, das Schema sei seit Jahren dasselbe, und einen Audit-Trail habe bisher niemand verlangt. Warum dann überhaupt eine Integrationsschicht? Man könne aus dem Staging direkt ins Star Schema laden, und schneller wäre das ohne Frage.
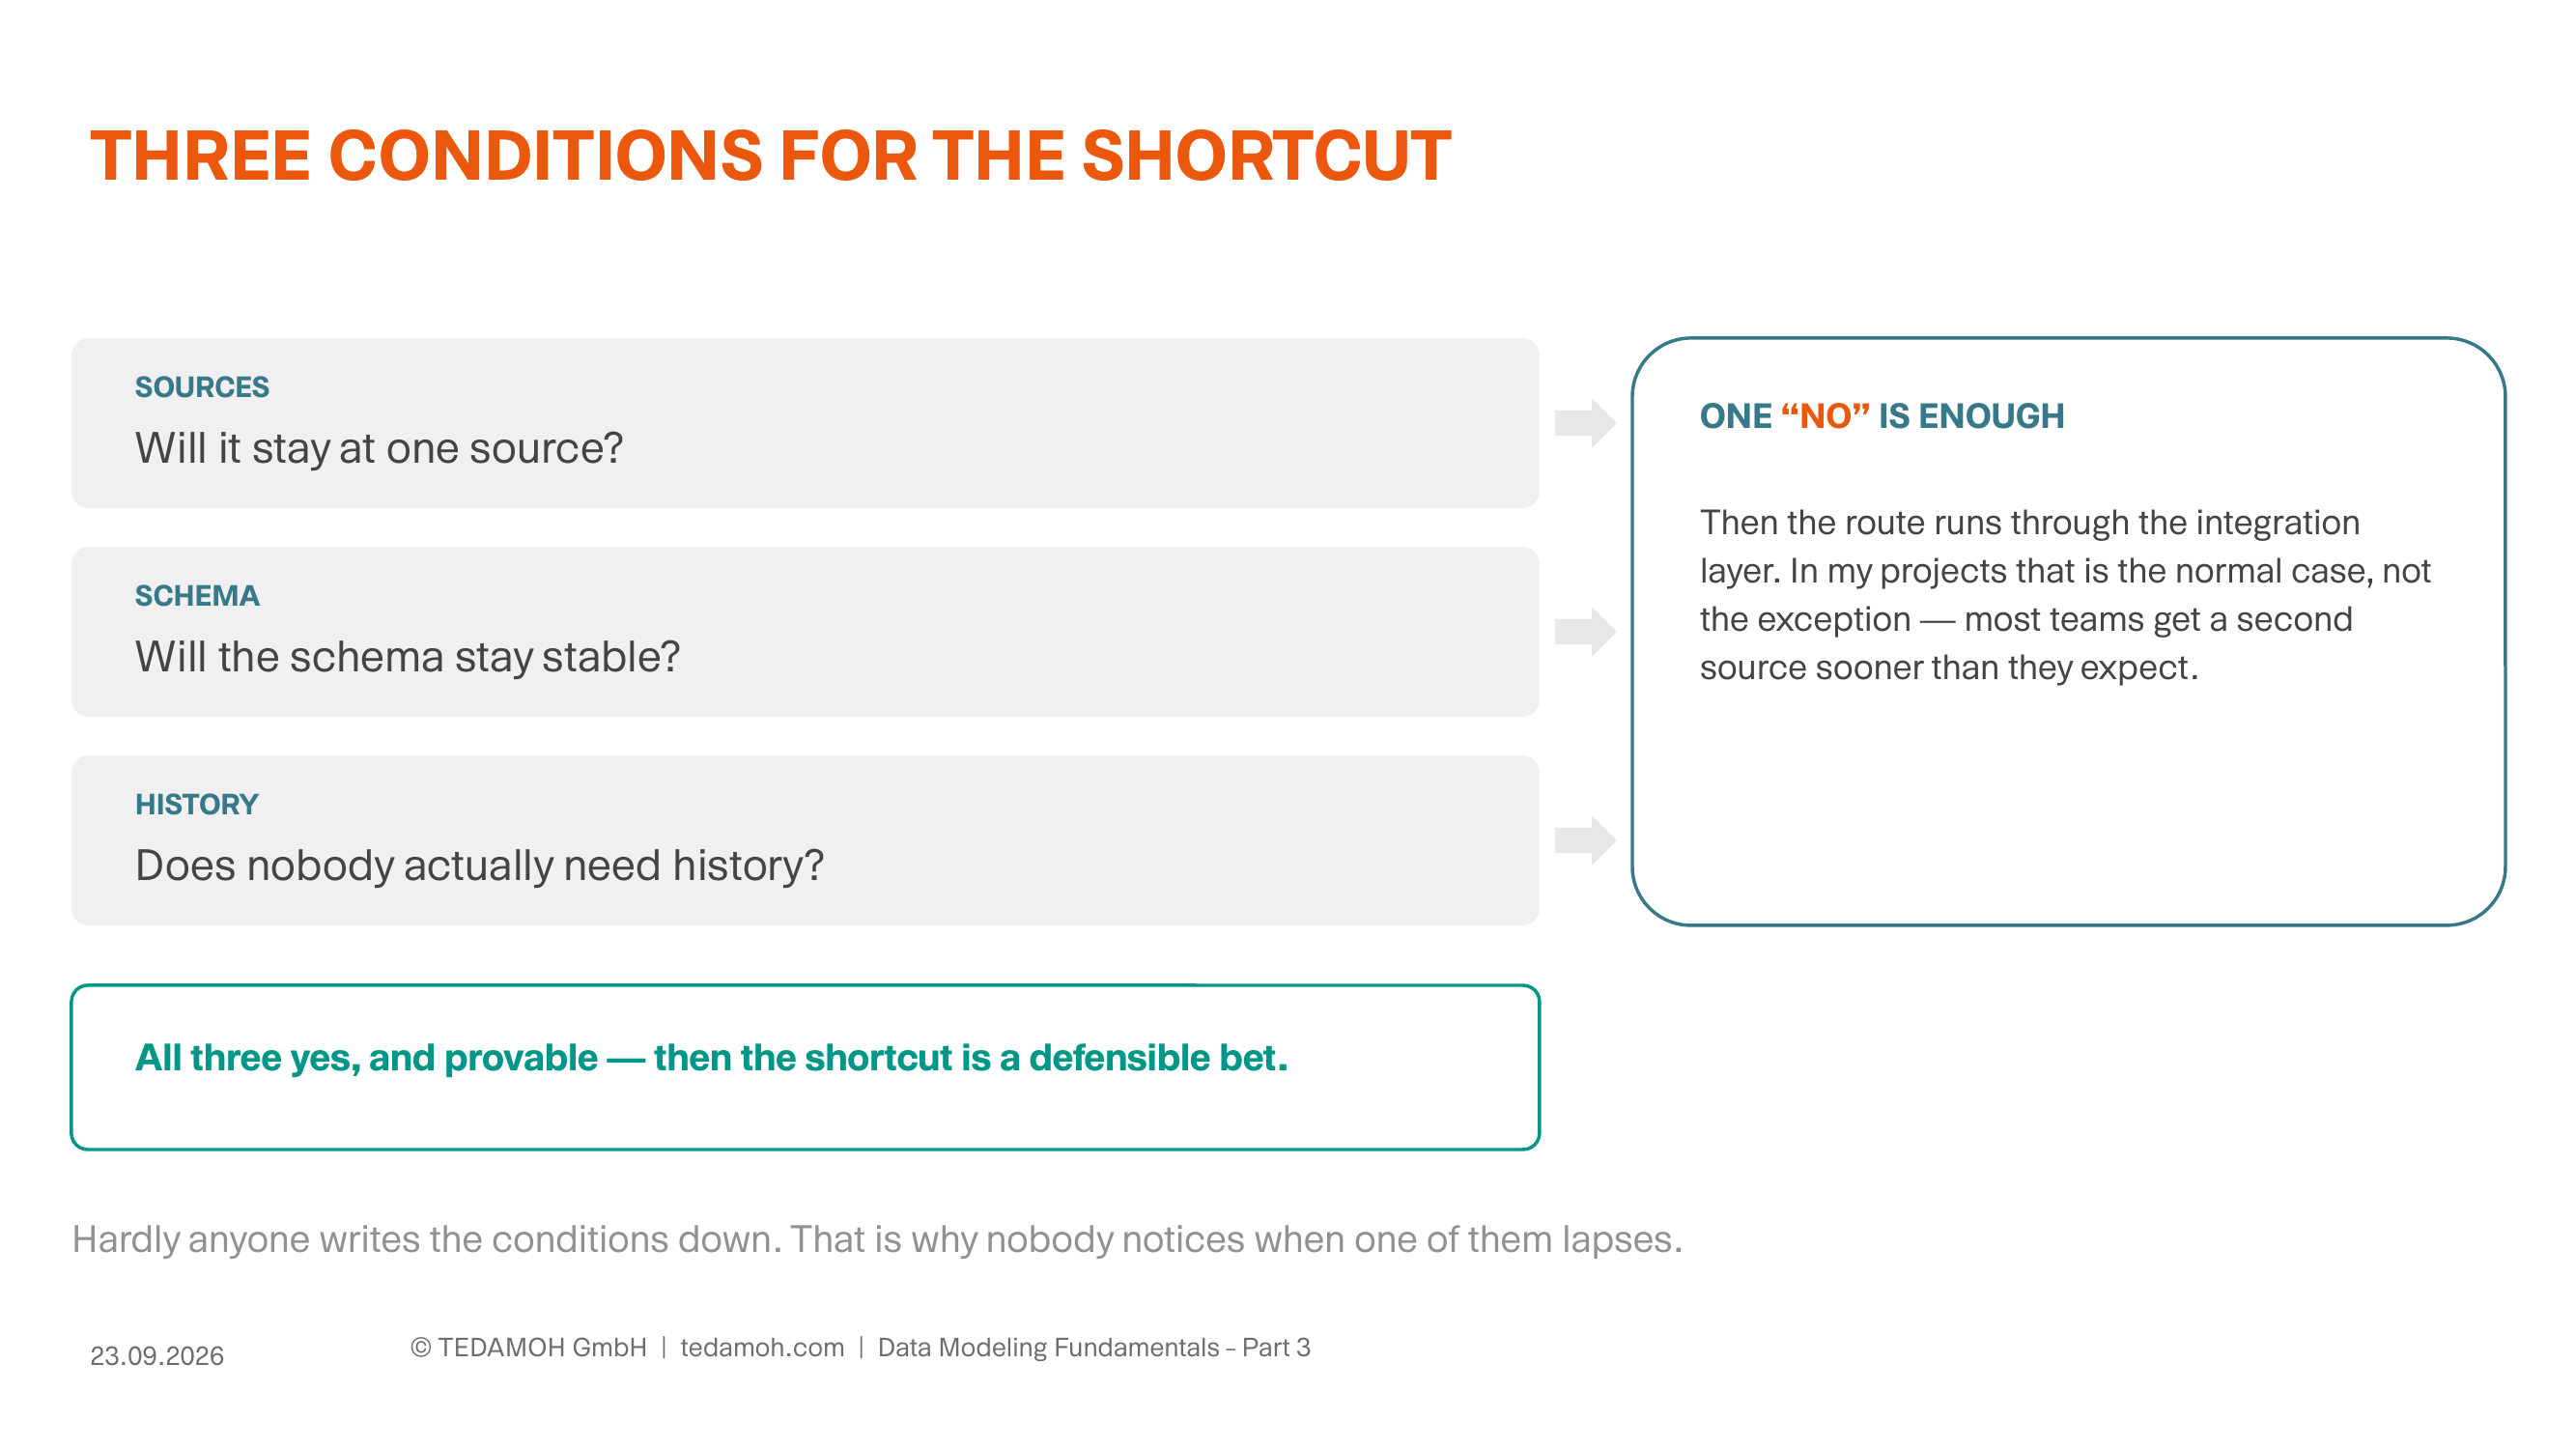
Drei Bedingungen, und nur wenn alle drei zutreffen, führt der Pfad an der Integrationsschicht vorbei.
Diese Abkürzung ist im Kern eine Wette, und sie hat Bedingungen: Bleibt es bei einer Quelle? Bleibt das Schema stabil? Braucht wirklich niemand die Historie? Wer alle drei mit Ja beantworten und die Antworten auch belegen kann, darf abkürzen.
Entfällt eine davon, kommt die Rechnung. Kommt eine zweite Quelle dazu, muss die Integration irgendwo passieren — dann eben im Star Schema selbst, oder es entsteht ein zweites daneben, mit eigenen Dimensionen. Ab da erklärt man, warum zwei Berichte verschiedene Zahlen zeigen. Wird Historie verlangt, baut man sie von Hand nach, als langsam veränderliche Dimensionen (SCD Type 2), und zwar in jeder Dimension einzeln. Ändert das Quellsystem sein Schema, wandert die Änderung ohne Zwischenschicht bis in die Berichte.
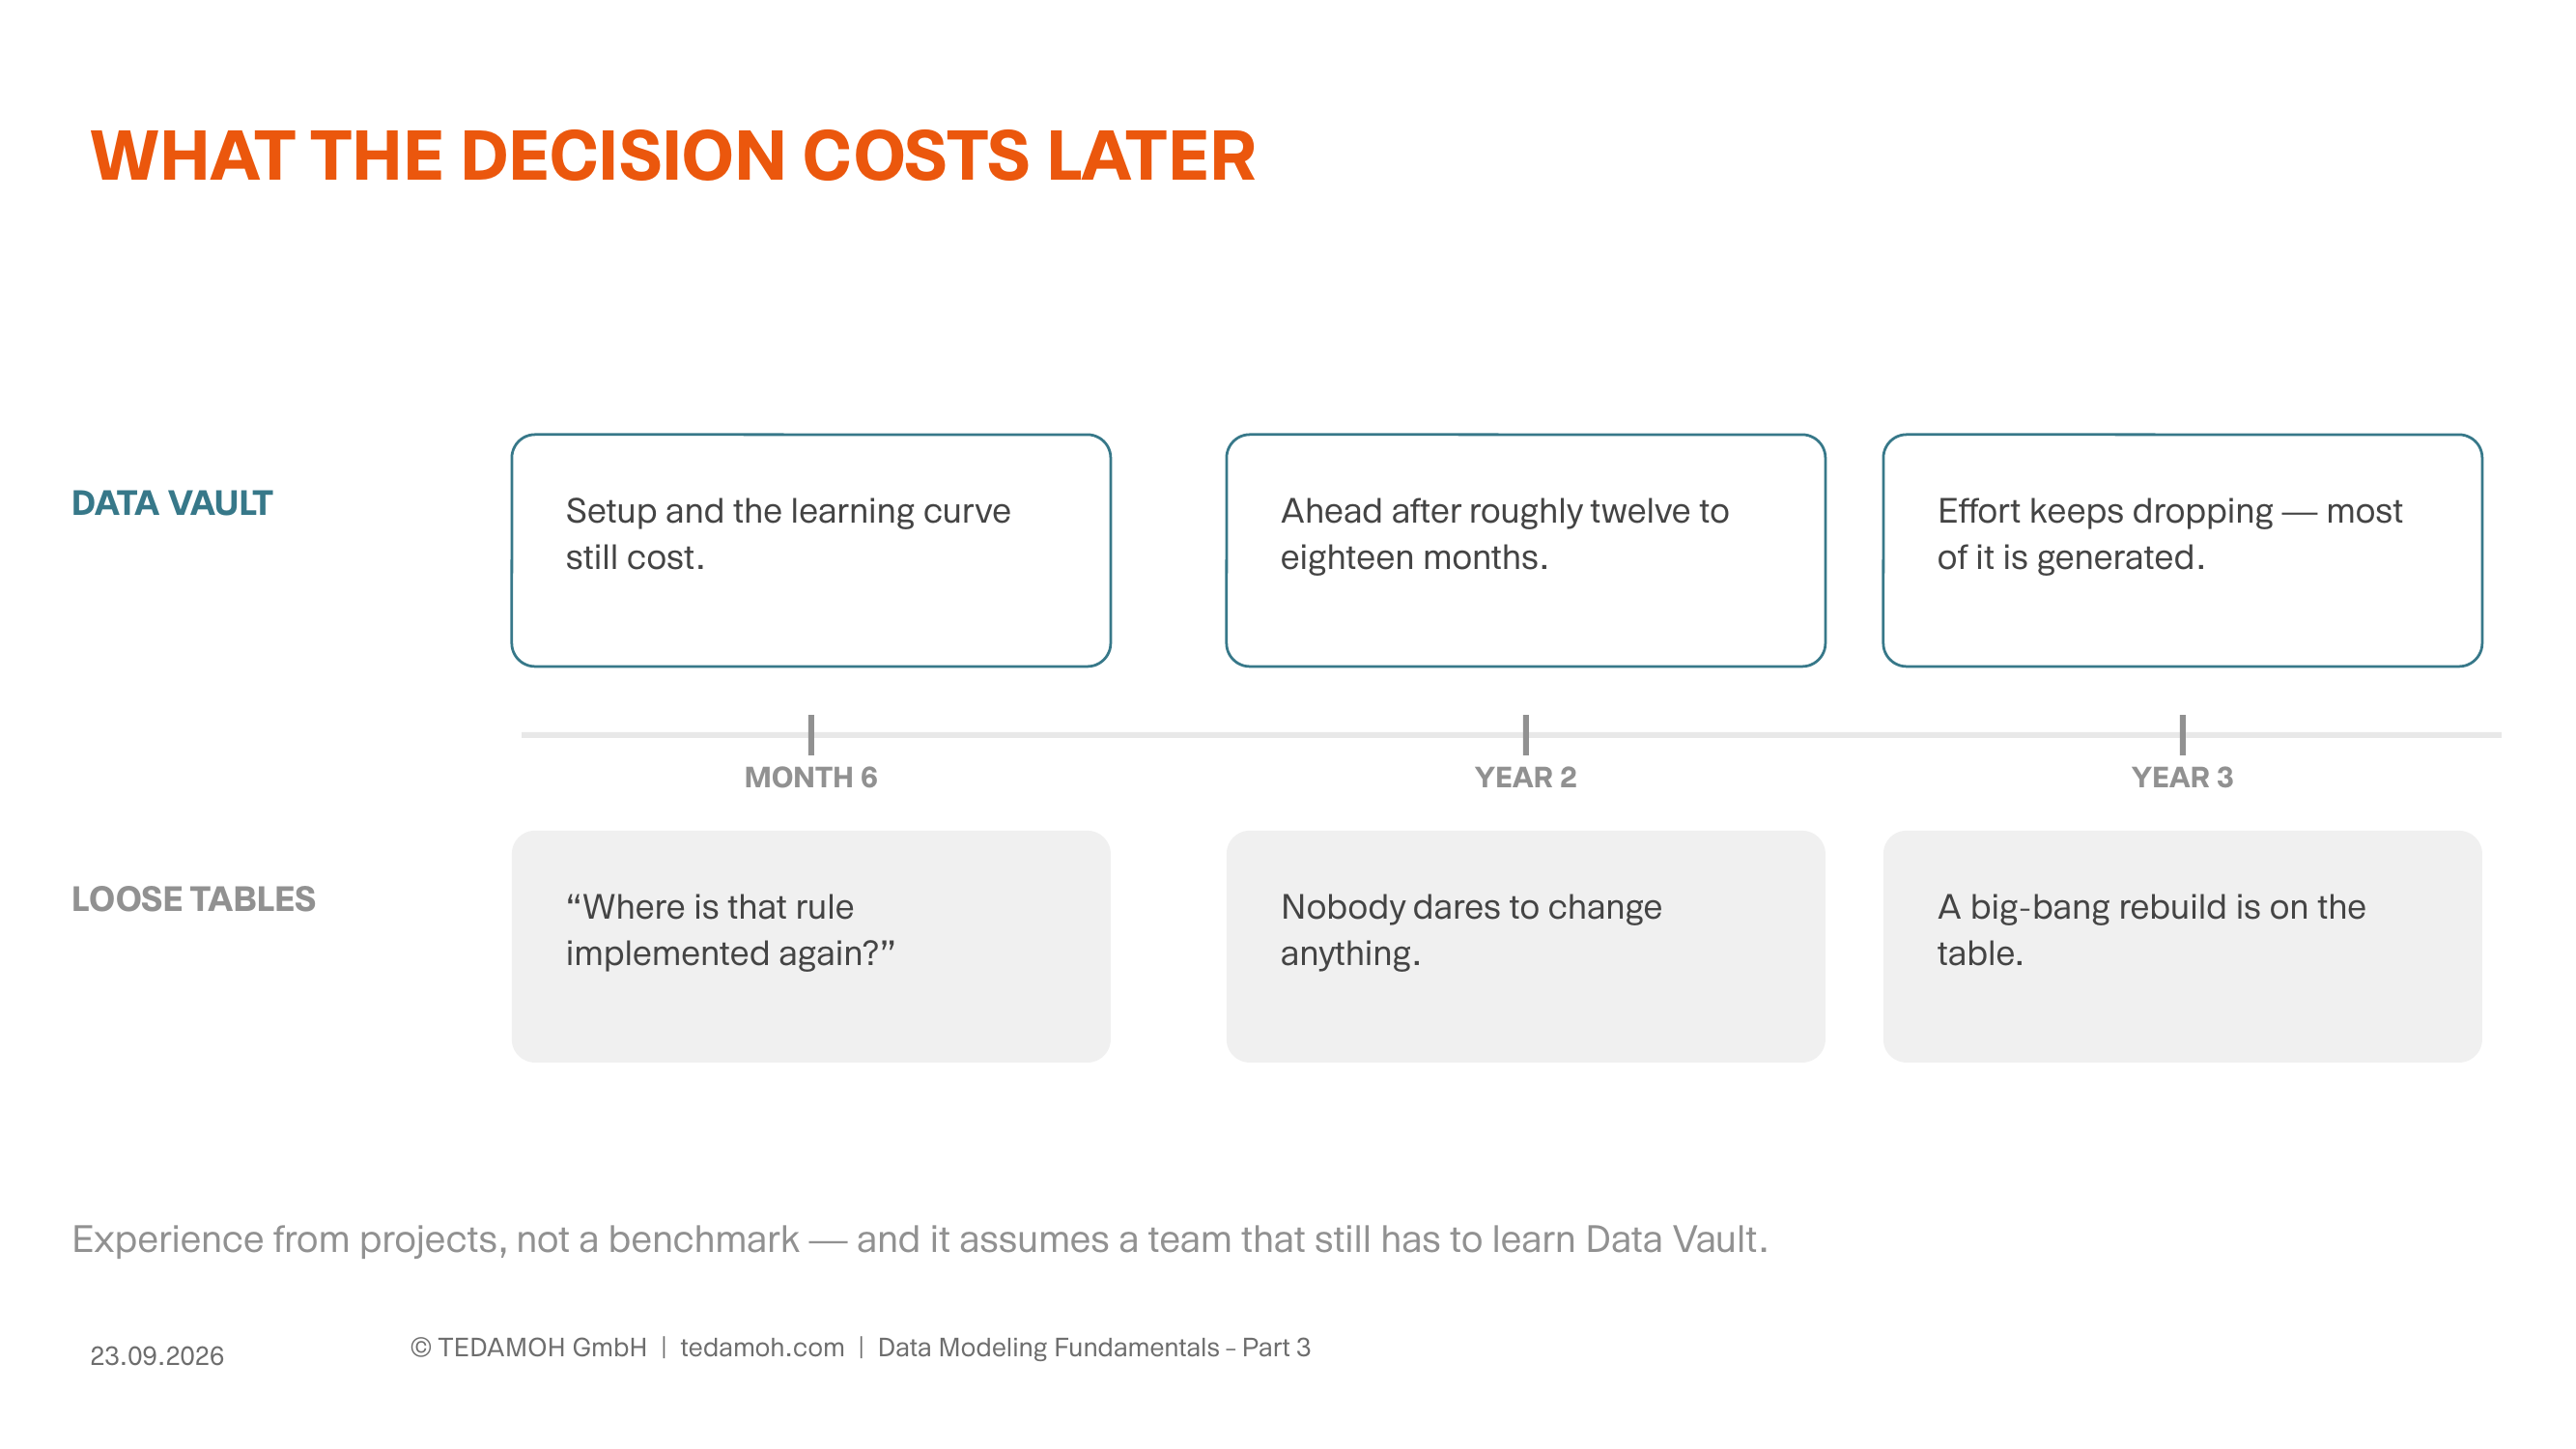
Die Entscheidung fällt in Woche eins. Bezahlt wird sie ab Monat sechs.
Was man am Anfang nicht sieht, ist der zeitliche Teil. In den ersten Monaten ist die schnellste Variante immer die mit losen Tabellen und einem Dashboard darüber: Der Fachbereich ist zufrieden, und es sieht gut aus. Nach einem halben Jahr fängt jemand an zu fragen, wo diese eine Regel eigentlich implementiert ist. Nach zwei Jahren traut sich niemand mehr, etwas zu ändern, und die Einarbeitung eines neuen Kollegen dauert Monate. Data Vault verhält sich genau umgekehrt: Lernkurve und Setup kosten am Anfang, nach etwa zwölf bis achtzehn Monaten liegt es vorn, und danach sinkt der Aufwand weiter, weil das meiste generiert wird. Die Zeiträume sind meine Erfahrungswerte aus Projekten, keine Messreihe, und sie gelten für ein Team, das 3NF im Haus hat und Data Vault erst lernen muss — bringt jemand die Erfahrung mit, verschiebt sich der Punkt nach vorn.
Bei FastChangeCo ist die erste Bedingung schon beim Hinsehen nicht erfüllt. Die Personaldaten kommen nicht aus einem System, sondern aus dem Personalsystem, dem Zeitmanagement und dem Vertragsmanagement für die Contractors — genau die drei Quellen, aus denen sich die Subtypen aus Teil 2 speisen. Michael Müller entscheidet den Weg durch die Integrationsschicht und schreibt in zwei Sätzen dazu, warum. Diese zwei Sätze sind meist das Einzige, was in drei Jahren noch erklärt, warum das System so gebaut ist.
Über diese Serie: Dies ist Teil 3 von 3 der Serie über die Grundlagen der Datenmodellierung. Die Übersicht steht im Hub-Artikel. Teil 1 ist einen einzelnen Begriff durch die drei Ebenen gegangen, Teil 2 hat an einem einzigen Begriff gezeigt, wie ein konzeptionelles Modell entsteht.
Die Methode ist entschieden, und keiner im Team hat sie je durchgezogen?
Genau da setzt das On Demand Coaching an: am eigenen Modell, mit den eigenen Quellen, in der eigenen Architektur — statt an einem Beispiel aus der Schulung.
Was die Methode übernimmt, und was sie mitbringt
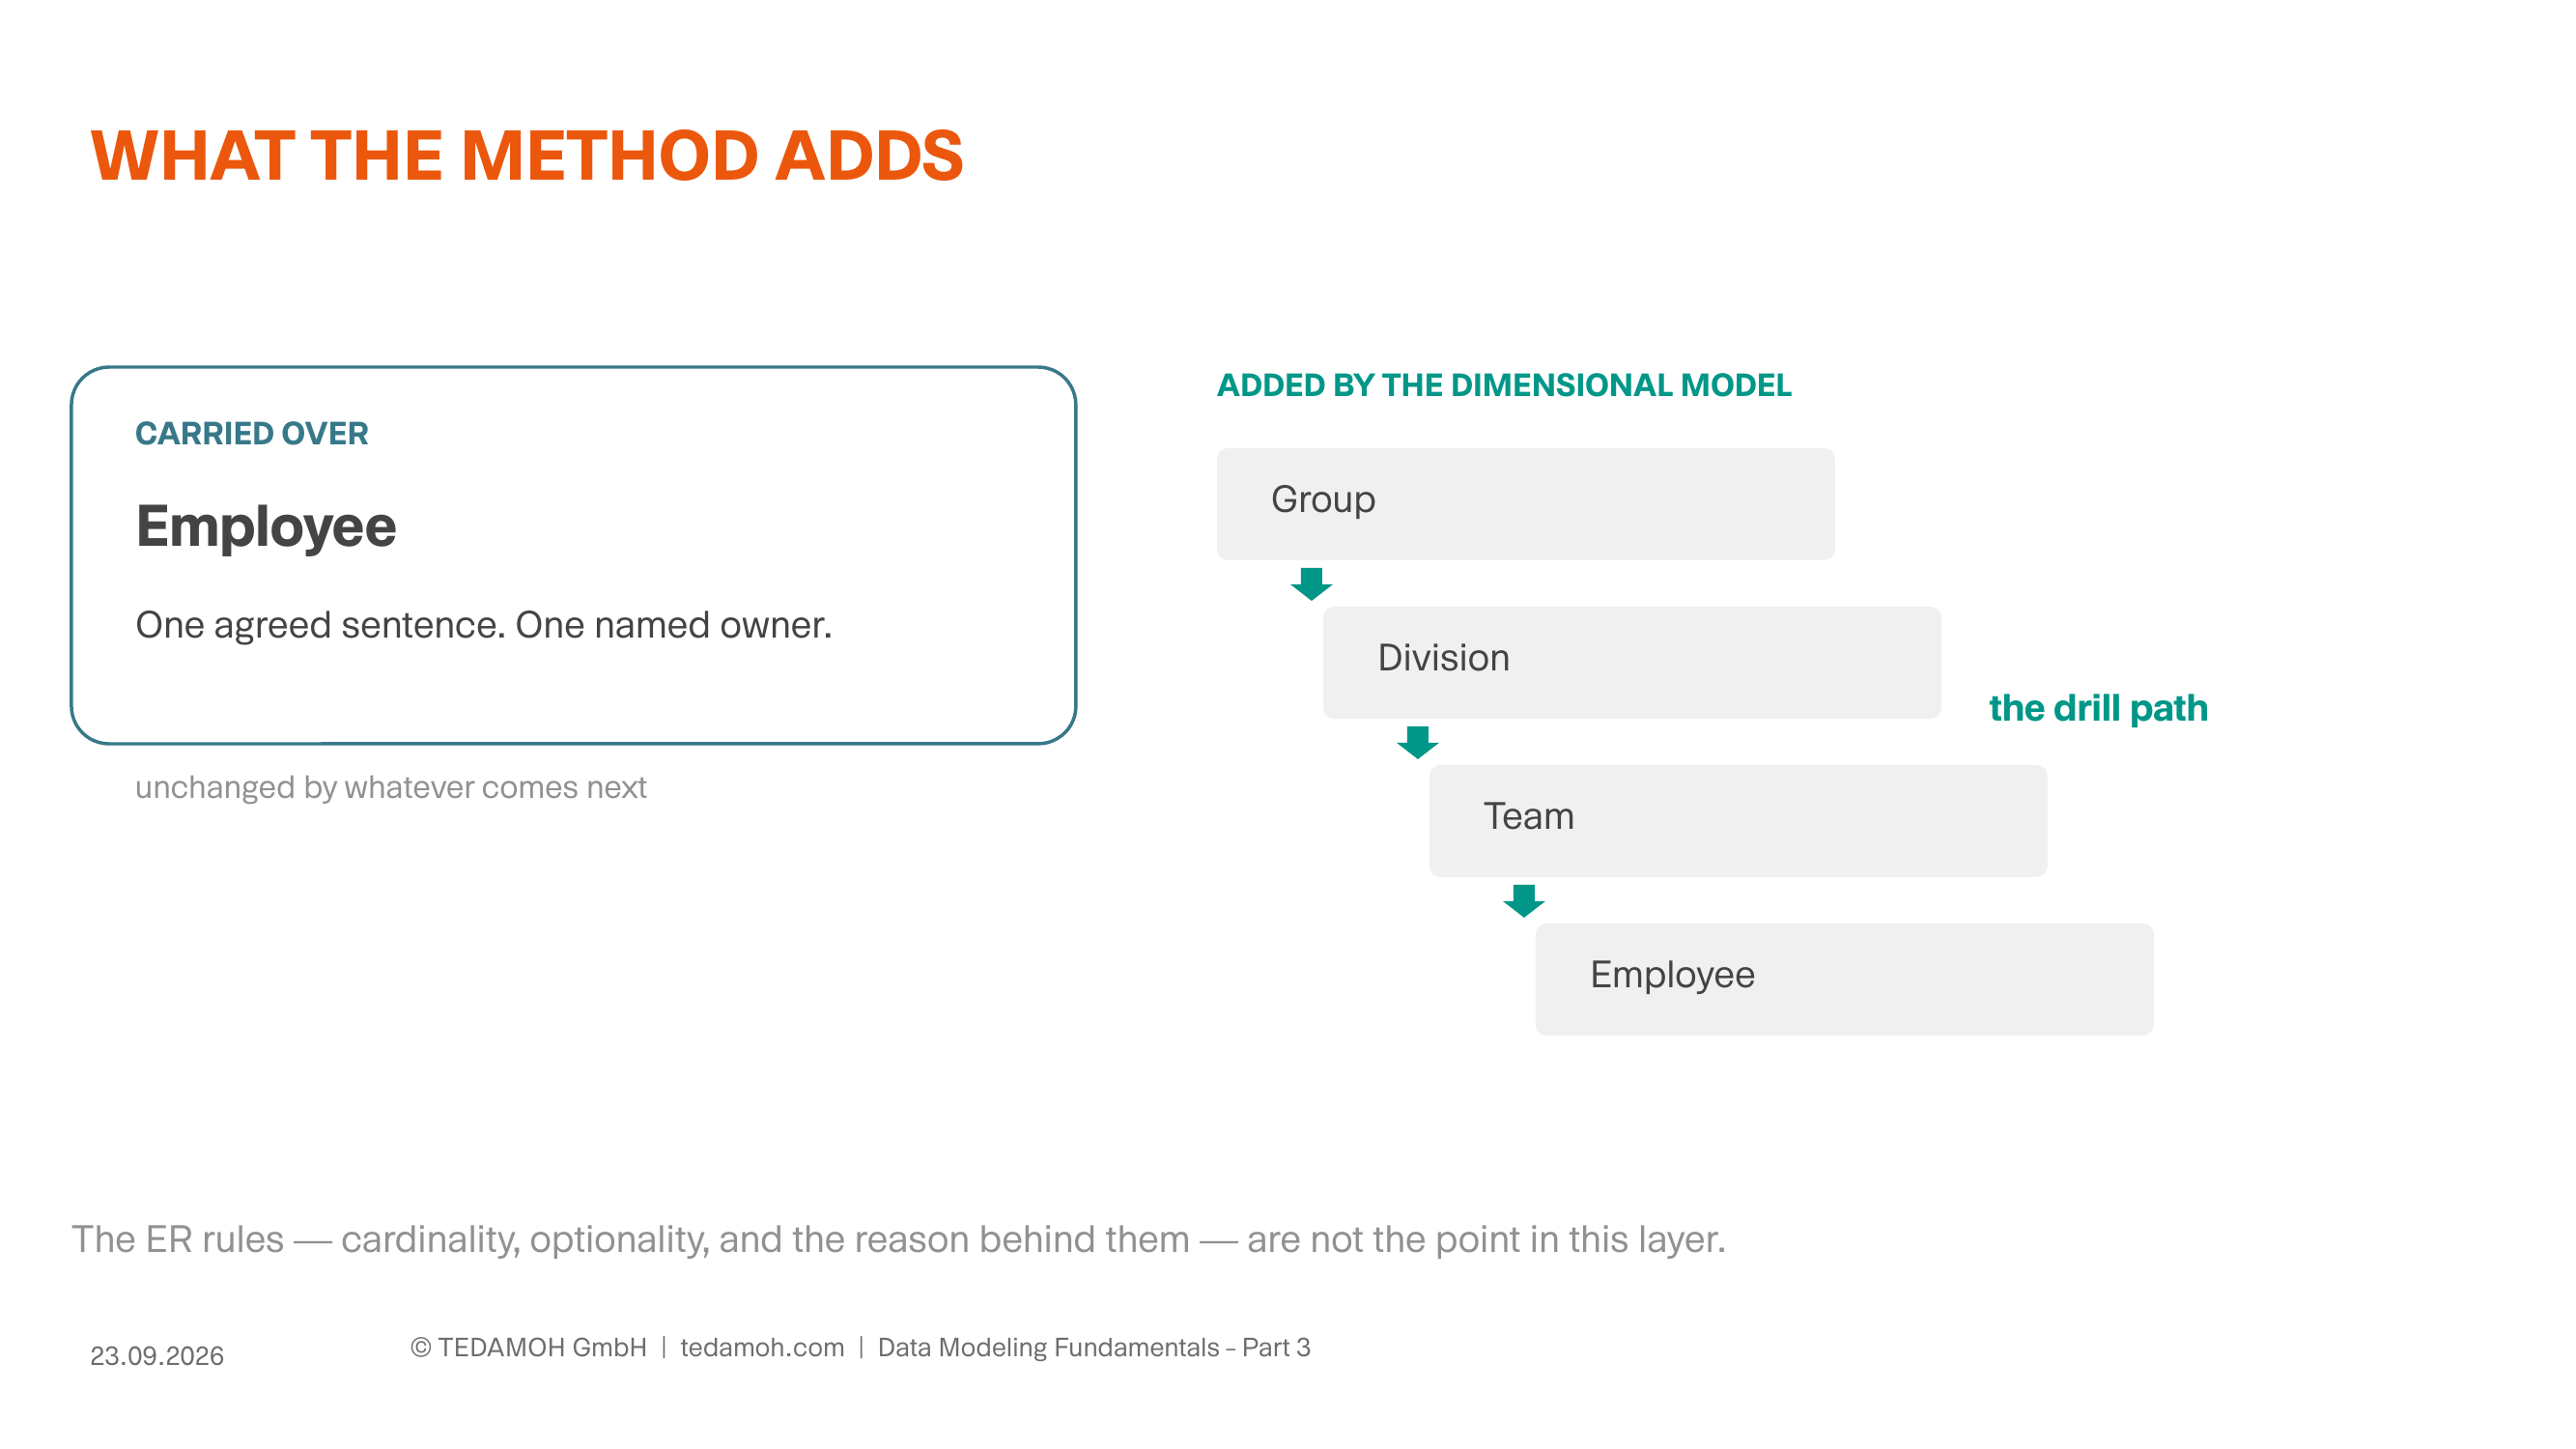
Die Definition wandert unverändert mit. Was dazukommt, sind die Wege, auf denen später ausgewertet wird.
Wie die Entscheidung auch ausfällt: Die Definition aus Teil 2 bleibt bestehen. Sie ändert sich nicht! Ein dimensionales Modell übernimmt Begriffe und Definitionen und bringt Eigenes dazu, das im Entity-Relationship-Modell gar nicht vorkommt — Hierarchien und die Pfade, auf denen man sich später durch eine Auswertung bewegt. Umgekehrt sind die Regeln aus dem ER-Modell, also Kardinalitäten und Optionalitäten samt dem fachlichen Grund dahinter, im Access Layer nicht mehr das Thema. Übrigens: Ob so eine Regel überhaupt ins Modell gehört oder eher eine Business Rule ist, habe ich vor einiger Zeit an einem 1:M-Link durchgespielt.
Woran man merkt, ob es taugt
Bleibt die Frage, mit der Teil 2 aufgehört hat: Woran erkennt man am Ende, ob das Ganze etwas taugt? Die härteste Prüfung dafür ist eine einzige Frage, und ich stelle sie gerne: Kann jemand Fachfremdes oder eine KI allein aus eurem Modell dieselbe Zahl bauen wie der Fachbereich? Wenn nein, dann fehlt euch nicht die Technologie oder noch ein anderes fancy Add-on, sondern dann fehlt euch das Informationsmodell.
Das ist die Gegenprobe auf die Zahl aus Teil 2: Wer sie besteht, hat die Definitionen nicht nur verhandelt, sondern auch so festgehalten, dass jemand ohne den Kontext damit rechnen kann.
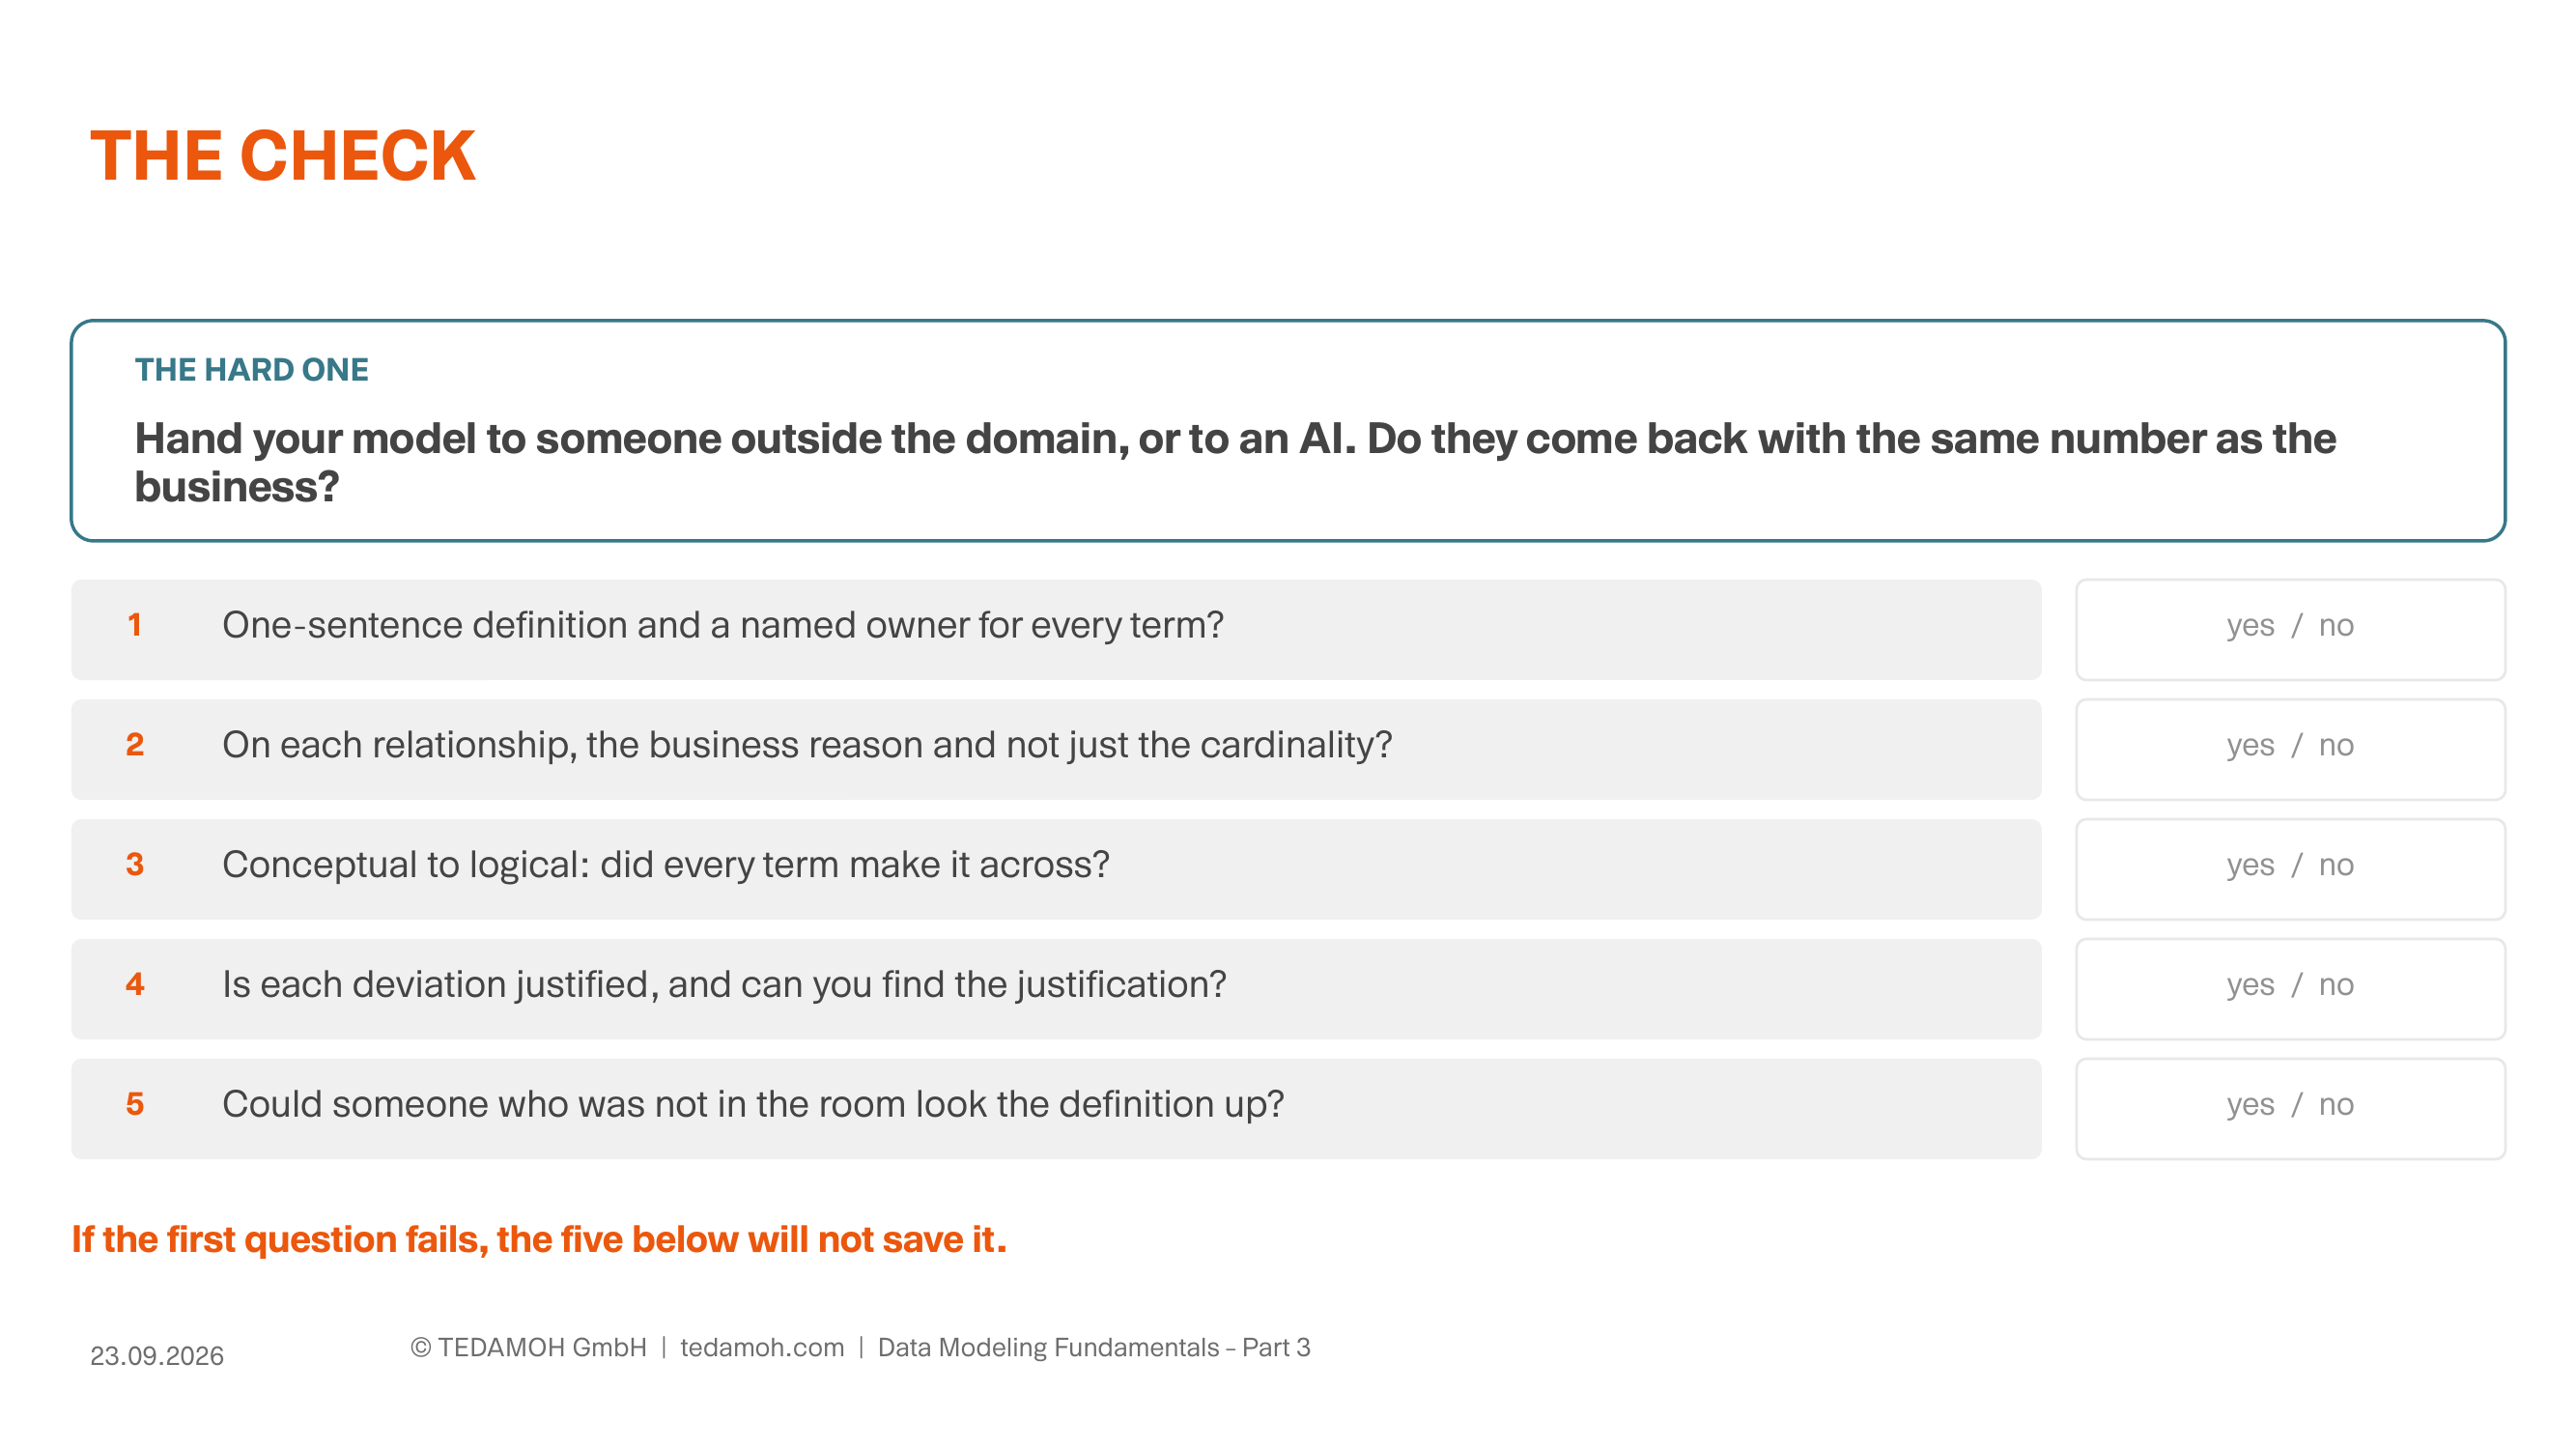
Fünf Fragen, die man am eigenen Modell in einer halben Stunde durchgehen kann.
Dazu fünf kleinere Prüfungen aus dieser Serie:
- Hat jeder Begriff eine Definition in einem Satz, und steht daneben, wer sie verantwortet?
- Bei den Beziehungen: Steht der fachliche Grund dabei oder nur die Kardinalität?
- Von der konzeptionellen zur logischen Ebene darf nichts verschwinden — alle Begriffe müssen weitergetragen sein.
- Bei der Implementierung: Jede Abweichung vom naheliegenden Weg ist begründet, und die Begründung steht irgendwo, wo man sie wiederfindet.
- Und zum Schluss: Kommt jemand an die Definition heran, der bei der Entscheidung nicht dabei war?
Für die ausgewachsene Fassung dieser Prüfung gibt es die Data Model Scorecard® mit zehn Kategorien, von Korrektheit über Abstraktion bis zu den Definitionen. Warum ich damit arbeite, habe ich an anderer Stelle aufgeschrieben. Für den Anfang reichen die fünf Fragen oben.
Damit ist die Serie durch. Im vierten Quartal geht es um Datenprodukte — und die setzen genau das voraus, was diese drei Teile gebaut haben: einen Begriff, auf den sich Menschen geeinigt haben, und ein Modell, in dem man ihn wiederfindet.
So long,
Dirk
Quellen
Der Schichtaufbau und die Entscheidungswege je Schicht stammen aus der Referenzarchitektur, die Roelant Vos und ich in Data Engine Thinking beschrieben haben. Die genannten Zeiträume sind Erfahrungswerte aus Projekten.
Die Data Model Scorecard® stammt von Steve Hoberman, Technics Publications, 2015.
Die Wüsten- und Stämme-Analogie stammt von Bill Reynolds und steht im Wortlaut in diesem Beitrag vom September 2026. Verwendung mit seiner Zustimmung.
FastChangeCo ist eine fiktive Firma; die Szenen im Beispiel sind erfunden.